¿Es seguro en un servidor de producción?
¿Es seguro en un servidor de producción?
Sí. El agente solo lee métricas locales y sus propios logs de autenticación, y se conecta saliente por TLS. No abre puertos entrantes ni tiene capacidad ofensiva.
Un agente ligero transmite métricas y señales de seguridad por TLS mutuo. Servers Sentinel puntúa cada host, alerta en los canales que ya usas y marca la fuerza bruta en cuanto empieza.
Primer servidor gratis. Sin tarjeta, instalación en una línea.
Pensado para flotas mixtas Windows y Linux
Para cuando el panel se refresca, el incidente ya tiene una hora. Servers Sentinel cierra esa brecha.
Un host deja de reportar y nadie lo nota hasta que lo hace un usuario. La cobertura no debería depender de quién mira la pantalla.
Cada herramienta tiene su bandeja. Las señales se dispersan entre correo, chat y webhooks hasta que todas se ignoran.
El adivinado de contraseñas por RDP y SSH corre horas antes de aparecer en la revisión de logs. Debería surgir en segundos.
Umbrales fijados por servidor se desincronizan con el tiempo. Un valor por defecto debería cascadear, con anulaciones por host encima.
Servers Sentinel recoge métricas localmente, las transmite por TLS mutuo y las condensa en una puntuación de salud y una alerta clara. Las plantillas globales cascadean a cada servidor; cualquier host anula una clave sin romper el valor por defecto.
Nada que compilar, ningún puerto entrante que abrir. Todo sale saliente por TLS.
Registra un host en el panel y obtén un comando de instalación de una línea con un token de alta efímero.
El script detecta SO y arquitectura, instala el agente como servicio y lo da de alta por mTLS.
CPU, memoria, disco y red llegan según un ritmo. Cada host recibe una puntuación de salud en vivo.
Las reglas disparan a correo, Telegram, Slack o webhook. La fuerza bruta se detecta en el agente y se marca al instante.
El bucle central hoy, con seguridad, discos y bases diseñados como módulos enchufables.
CPU, memoria, disco y red por host, guardadas como series temporales y dibujadas en sparklines legibles de un vistazo.
Las plantillas globales fijan los valores por defecto; cada servidor anula solo las claves necesarias. Las anulaciones cascadean, nunca bifurcan.
Cada agente tiene un certificado de cliente. La ingesta está autenticada mutuamente: un token filtrado por sí solo no abre nada.
El agente vigila la autenticación RDP y SSH localmente y reporta un ataque activo con las IP de origen principales.
Cada host se reduce a una única puntuación 0-100, así una flota de cientos se ordena por lo que necesita atención.
Correo, Telegram, Slack y webhooks. Añade un canal, envía una prueba y enruta reglas hacia él.
Usuarios, equipos y roles (lector, operador, admin) aíslan la flota de cada cliente tras un único acceso.
Un protocolo para una unidad systemd en Linux y un servicio de Windows, en amd64, arm64 y 386.
Empieza gratis en un servidor. Paga por número de hosts, al mes o al año.
Regístrate y vigila toda tu flota: historial de métricas, comprobaciones de disponibilidad y de API, alertas de Telegram e informes. Al terminar no se cobra nada: la cuenta vuelve a Free y la monitorización de un servidor sigue funcionando.
Quince situaciones en las que no saber qué está haciendo un servidor deja de ser un riesgo aceptable. Si reconoce su propio parque en alguna de ellas, el hueco ya está ahí: sencillamente todavía no le ha costado nada.
El primer grupo trata de lo que pasa desapercibido. Ninguna de estas situaciones es negligencia: aparecen en cuanto el número de máquinas supera al que una persona puede tener en la cabeza, que en la mayoría de los equipos son unas cuatro.
Una máquina deja de reportar. Puede haberla reiniciado un hipervisor, puede haber perdido la ruta, haberse quedado sin memoria, o simplemente haberla apagado alguien que ordenaba un bastidor. Nada lo anuncia: un servidor ausente no genera ningún error, y el silencio es exactamente lo que produce también uno sano.
Todo el problema está en el hueco entre el fallo y la llamada. Suele medirse en horas, siempre lo descubre la peor persona posible, y para entonces la pregunta ya no es qué se rompió, sino por qué no lo sabía nadie.
Quedarse sin disco es la caída más previsible que existe. Los registros crecen, una copia se escribe dos veces, una tabla temporal no se limpia nunca, y la curva de espacio libre lleva quince días apuntando al mismo día.
Es además la caída cuya recuperación sale más cara, porque una base de datos que se queda sin espacio a mitad de una escritura no se detiene con educación. La diferencia entre un aviso al 80 % y una llamada al 100 % es la diferencia entre dos minutos de limpieza y una restauración desde la copia de anoche.
Fugas de memoria, agotamiento del grupo de conexiones, una cola que se vacía un poco más despacio cada día, un certificado a un mes de caducar: nada de eso es un evento. Son pendientes, y una pendiente es invisible para quien solo mira el valor actual.
Sin histórico no hay nada con lo que comparar. «¿Un 70 % de memoria es normal en este host?» no tiene respuesta si nada registró qué era lo normal, y ese registro tenía que estar funcionando antes de que a nadie se le ocurriera preguntar.
La mayoría de los parques reales son mixtos: un par de servidores Windows para la contabilidad y el recurso compartido, un puñado de máquinas Linux para la web y la base de datos, quizá algo en ARM en una sede remota. Cada plataforma tiene sus propias herramientas nativas y ninguna habla con la otra.
Así que el cuadro se monta a mano, en la cabeza de quien esté de turno, a partir de una consola de servicios, una sesión SSH y el panel del proveedor. Y se monta solo cuando alguien va a mirar, es decir, cuando algo ya ha salido mal.
Un servidor en la oficina, dos en un proveedor, tres en una nube, uno en otra por una migración que nadie terminó, y una caja en una delegación instalada antes de que llegara el equipo actual. Cada uno tiene su espacio de direcciones, su vía de acceso y su responsable.
No hay una consola única que los abarque, porque nunca se compraron como una sola cosa. Lo que hace falta es un sitio que los trate como un solo parque, independientemente de dónde esté físicamente cada uno.
El segundo grupo trata de la distancia entre «era detectable» y «alguien hizo algo». La mayoría de los incidentes que duelen estuvieron visibles en un registro todo el tiempo; el fallo ocurrió en los últimos metros, entre la máquina y un ser humano.
Un sistema manda correos, otro publica en un canal de chat, un tercero dispara un webhook, el proveedor envía SMS, y el software de copias deja un informe en una carpeta que nadie ha abierto desde que se configuró.
Nada se correlaciona. El mismo incidente produce cuatro notificaciones con cuatro nombres distintos en cuatro sitios, y el trabajo de darse cuenta de que son el mismo incidente le toca a quien casualmente estaba mirando la ventana correcta.
Una monitorización sin ajustar alerta sin parar: un pico de CPU durante una tarea nocturna, un disco que cruza un umbral que cruza todas las semanas, un servicio que se reinicia tal y como está previsto. La gente aprende muy rápido que eso se puede ignorar, y tiene razón hasta el día en que no la tiene.
Una vez que un canal ha enseñado a sus lectores a saltárselo, añadir más alertas empeora las cosas en lugar de mejorarlas. La medida útil no es cuánto se detecta, sino cuánto llega a alguien que después hace algo.
Los equipos pequeños y medianos no llevan turnos. La persona que conoce los sistemas está durmiendo, en un avión o de vacaciones, y al incidente le da igual. Por eso todo tiene que ser comprensible para quien esté realmente disponible, incluida una persona que no construyó nada de esto.
Eso impone un requisito duro a lo que una alerta debe decir. «db-01 CPU 96 %» no significa nada a las tres de la madrugada para alguien que nunca ha entrado en db-01; qué ocurrió alrededor y a qué se parece lo normal marcan la diferencia entre arreglarlo y encadenar llamadas.
Cada servidor se configuró a mano, en un momento distinto, por una persona distinta, con una idea distinta de qué justifica despertar a alguien. Dos años después no hay dos máquinas que coincidan, nadie recuerda por qué una está al 85 % y otra al 95 %, y cambiarlas todas significa visitarlas todas.
Lo que un parque necesita es otra cosa: un valor por defecto que se propague a todas partes y excepciones por host visibles como excepciones, para que una desviación sea una decisión deliberada y revisable, y no un accidente de la historia.
Un puerto RDP o SSH expuesto está bajo ataque de forma continua, y una contraseña acertada se parece, en el registro, casi exactamente a un acceso normal. Las pruebas están ahí -una subida de fallos, un origen desconocido, un primer acceso con éxito desde un país nuevo-, pero solo como líneas en un fichero que nadie lee a diario.
La detección, por tanto, tiene que ser algo que hace la máquina y no algo que hace una persona una vez al trimestre. La ventana que importa es la que va del primer intento al primer acierto, y suele medirse en horas.
El tercer grupo trata del momento en que alguien de fuera del equipo técnico necesita una respuesta. La disponibilidad, el historial de incidentes y la prueba de que se estaba vigilando existen como registro o no existen en absoluto: no se reconstruyen después de memoria.
En cuanto la disponibilidad se escribe en un acuerdo, deja de ser una sensación y pasa a ser una cifra que hay que presentar cada mes, defender si se discute y calcular igual todas las veces. «Que sepamos, estuvo funcionando» no es una medición.
El registro también protege en el sentido contrario. La mayoría de las discusiones sobre disponibilidad van sobre de quién fue la culpa de una caída, y una cronología que muestra que el host estaba sano mientras el enlace del propio cliente estaba caído zanja la conversación más rápido que cualquier argumento.
Las solicitudes de ciberseguro, las revisiones de proveedores y los marcos regulatorios de datos de pago y personales preguntan todos una variante de lo mismo: cómo sabe usted que sus sistemas funcionan como deben, y cómo se enteraría de que han dejado de hacerlo.
Lo que se pide no es el nombre de una herramienta. Es prueba de que la supervisión fue continua durante el periodo revisado, de que las alertas fueron a un sitio donde una persona las leía, y de que los incidentes quedaron registrados en lugar de recordados.
Los proveedores de servicios gestionados, los administradores de sistemas autónomos y las pequeñas empresas de informática llevan decenas de máquinas repartidas entre empresas, proveedores y arquitecturas de red distintas. Cada cliente tiene su horario, su tolerancia a la interrupción y su propia idea de qué es urgente.
Configurarlas de una en una a mano no escala, ni tampoco enterarse de un problema solo cuando llama el cliente. Un parque así necesita una base común aplicada en todas partes, excepciones por cliente allí donde uno realmente difiere, y un único muro donde se vea todo a la vez.
Qué máquina importa, cómo es una carga normal en ella, qué alerta se puede ignorar sin riesgo, por qué aquel umbral se subió en marzo: nada de eso está escrito en ninguna parte. Lo lleva encima quien lo montó todo, y se va con esa persona.
Un relevo se convierte entonces en un proyecto de arqueología, y los primeros meses en manos nuevas se van en redescubrir lo que un año antes se sabía perfectamente. Un histórico y una configuración que viven fuera de una persona son la única defensa contra eso.
Supervisar no está libre de riesgo. Cualquier cosa que lea métricas de todas sus máquinas tiene, por definición, un punto de apoyo en todas sus máquinas, y además es alcanzable desde fuera, porque de eso se trata.
Así que la pregunta de cómo se vigila el parque es también una pregunta sobre ese canal: quién puede hablar con él, qué identidad demuestra cada parte, qué ocurre con los datos en tránsito y si una consola comprometida entregaría el parque entero. Es una pregunta legítima antes de instalar nada en ningún sitio.
Sí. El agente solo lee métricas locales y sus propios logs de autenticación, y se conecta saliente por TLS. No abre puertos entrantes ni tiene capacidad ofensiva.
Sí. Un protocolo maneja una unidad systemd en Linux y un servicio de Windows, en amd64, arm64 y 386. El instalador detecta la plataforma por ti.
Cada agente se da de alta con un certificado de cliente y transmite por TLS mutuo. Un token de alta robado es efímero y no puede suplantar a un host ya dado de alta.
Defines las plantillas globales una vez. Cada servidor anula claves individuales; las anulaciones cascadean sobre los valores por defecto en vez de reemplazarlos, así un cambio de plantilla llega a cada host.
Sí. El panel se entrega como stack docker-compose tras Traefik con Postgres (TimescaleDB opcional). Consulta la guía de despliegue en el repositorio.
El agente vigila la autenticación RDP y SSH localmente, así que marca un ataque activo y sus IP de origen principales en segundos, incluso antes de que el panel se refresque.
Con los Servers Sentinel, instalo el agente como una unidad systemd o un servicio de Windows, lo conecto con un canal de salida mTLS y veo la telemetría más reciente y la puntuación del estado del host. Establezco una regla para los datos faltantes, envío una notificación por correo, Telegram, Slack o webhook y verifico la brecha de la prueba; Puedo mantener un servidor en un plan gratuito con notificaciones por correo electrónico.
Gratis sin Servers Sentinel Ejecuto blackbox_exporter/Prometheus o una verificación cron de ping/TCP desde otro sitio, almaceno last_seen y envío una alerta a través de Alertmanager. Compruebo por separado el monitoreo en sí con un interruptor de hombre muerto externo, configuro el retraso para un reinicio normal y documento al propietario del host; de lo contrario, la pérdida del sistema de seguimiento aparece como un estado verde.
Con los Servers Sentinel, recopilo el espacio libre y usado de cada sistema de archivos como una serie de tiempo, establezco un umbral general y una anulación separada para un volumen específico, y envío una notificación antes del valor crítico. Miro la tasa de crecimiento junto al porcentaje actual, verifico el inodo en Linux y dejo suficiente margen para WAL/log y operación de emergencia.
De forma gratuita, instalo node_exporter/windows_exporter con Prometheus y Alertmanager o ejecuto df/Get-Volume mediante cron/Task Scheduler. Advierto por porcentaje y gigabytes absolutos al mismo tiempo, agrego rate/predict_linear para un horizonte de 24 a 72 horas, configuro logrotate/retention y pruebo la alerta llenando artificialmente un volumen no crítico.
Con los Servers Sentinel almaceno una serie de CPU, memoria, disco y red, comparo el host con su propio historial y acumulo el estado actual en una puntuación de 0 a 100. Establezco la duración de la condición para no reaccionar ante un pico de un minuto y creo comprobaciones separadas de tiempo de actividad/TLS/API donde la duración del certificado o la respuesta de la aplicación son importantes.
Implemento Prometheus, exportadores y Grafana de forma gratuita, establezco reglas de registro para la línea de base y alertas para el crecimiento sostenible, y verifico los certificados con blackbox_exporter. Almaceno al menos algunas semanas de datos, marco la implementación/mantenimiento en los gráficos y uso la tasa/derivación solo para métricas relevantes; Apoyo TSDB y me gobierno yo mismo.
Con los Servers Sentinel uso un protocolo para el servicio de Windows y el agente systemd en amd64, arm64 y 386, obtengo las mismas métricas base y el mismo puntaje de salud. Mantengo las diferencias de plataforma en las anulaciones, pero clasifico toda la flota por riesgo y paso la telemetría a mTLS sin abrir el puerto de entrada del agente.
De forma gratuita, combino windows_exporter y node_exporter en un Prometheus, normalizo las etiquetas de host/cliente/os y construyo un panel de Grafana común. Asigno el reenvío de eventos de Windows y syslog/Loki por UTC, describo los diferentes umbrales para el sistema operativo como código y verifico que la actualización del exportador no cambie los nombres de las métricas sin migrar las reglas.
Con Servers Sentinel instalo un agente en cada host; inicia la conexión saliente por sí mismo y está autenticado mediante el certificado de cliente mTLS. Asigno etiquetas de sitio y de propietario, veo todos los hosts en una consola y establezco reglas globalmente con anulaciones punto por punto, sin crear una ruta entrante a cada máquina.
De forma gratuita, conecto sitios de WireGuard y exportadores de encuestas con Prometheus central o uso Remote_write/agents que envían métricas externamente. Limito la ACL solo a la dirección del recopilador, la protejo con certificados TLS, almaceno los datos cuando se rompen y superviso la propia VPN; Yo mismo hago el diseño de la red y la rotación de claves.
Con los Servers Sentinel creo canales de correo electrónico, Telegram, Slack o webhook en una consola, les envío una prueba y les envío reglas de acuerdo con los hosts requeridos. Utilizo nombres únicos y contexto de host para que el operador vea la métrica, el umbral y el tiempo, en lugar de recopilar un incidente a partir de cuatro letras independientes.
De forma gratuita, dirijo Prometheus Alertmanager a una puerta de enlace de notificación, configuro group_by, group_wait, repetir_interval e inhibición, y dejo a las fuentes un enlace a un runbook. Normalizo las etiquetas de gravedad/servicio/propietario y reviso rutas con alertas de prueba; Los SMS y los proveedores externos pueden seguir cobrando incluso con software gratuito.
Con los Servers Sentinel, establezco umbrales globales, duraciones de condiciones y excepciones puntuales para hosts donde la norma es diferente, y luego dirijo los niveles de gravedad a diferentes canales. Utilizo la puntuación de estado para priorizar, probar la regla y revisar las alertas sobre las que no se ha actuado.
De forma gratuita, mantengo un catálogo de alertas con un propietario y un runbook, uso for en Prometheus, agrupación e inhibición en Alertmanager y cierro el trabajo programado con silencio y finalización automática. Mido la cantidad de notificaciones, reconocimientos y reintentos, elimino señales no procesables y no enmascaro el ruido simplemente elevando todos los umbrales.
Con los Servers Sentinel, separo la gravedad y los canales, agrego una función/cliente al nombre de host y solo configuro la regla después de una infracción persistente. Reviso el mensaje con una prueba, dejo un enlace al runbook en el webhook del destinatario y uso un gráfico de métricas/evaluación de salud para que la persona de turno pueda distinguir un pico único de la degradación.
De forma gratuita, creo un cronograma de enrutamiento de Alertmanager, envío eventos críticos a una llamada o chat a través de una puerta de enlace disponible y el resto a la cola diaria. Escribo un runbook de tres acciones, un propietario y un criterio de escalamiento, agrego un enlace al panel y emito alertas de capacitación periódicamente; El canal de llamada gratuita depende del servicio seleccionado.
Con Servers Sentinel configuro una plantilla de configuración global y en un servidor específico anulo solo la clave deseada; la anulación se aplica en cascada sobre el valor predeterminado en lugar de copiar toda la configuración. Veo la desviación como una excepción, cambio el umbral general una vez y verifico qué hosts permanecieron deliberadamente en un valor diferente.
De forma gratuita, almaceno reglas de Prometheus y parámetros de inventario en Git, genero reglas Jsonnet/Ansible y solicito una revisión con el motivo y la fecha límite de la excepción. Ejecuto una verificación de sintaxis de CI, una diferencia de la configuración implementada y un informe sobre anulaciones; Sin esa disciplina, incluso una pila libre rápidamente vuelve a la deriva manual.
Con los Servers Sentinel habilito la detección de autenticación local: un agente en Windows o Linux lee eventos RDP/SSH y transmite un ataque activo con una fuente de IP superior. Dirijo la regla al canal en vivo y hago coincidir una fuente entre los hosts; La función de detección está disponible en un plan de prueba o pago elegible.
De forma gratuita recopilo Windows 4625 y sshd Contraseña fallida en Wazuh/Elastic o Loki, creo una correlación mediante source_ip para una ventana deslizante y una alerta para el posterior 4624/Aceptado exitoso. Sincronizo la hora a través de NTP, normalizo IPv4/IPv6 y excluyo los escáneres de prueba; la ruta gratuita requiere un recopilador independiente y soporte de reglas.
Con los Servers Sentinel creo comprobaciones TCP/TLS/API desde un punto externo, almaceno un historial de resultados y separo la indisponibilidad de la aplicación de la telemetría del agente faltante. Establezco un SLO, registro el mantenimiento y genero un informe periódico con límites de tiempo; Antes de firmar, acuerdo con el cliente el intervalo, las regiones de inspección y las reglas de exclusión.
De forma gratuita, implemento blackbox_exporter y Prometheus fuera del sitio controlado, considero la disponibilidad como sondas exitosas/sondas esperadas y almaceno eventos de Alertmanager. Anoto el mantenimiento en un registro separado, sincronizo UTC y genero un informe de Grafana; un punto de verificación no prueba la disponibilidad global, por lo que si es necesario agrego una sonda independiente.
Con los Servers Sentinel guardo el historial de métricas, comprobaciones de tiempo de actividad, configuración de reglas, canales y eventos, y uso el registro de auditoría para cambios de propietario y políticas en el plan apropiado. Subo un informe para el período exacto, adjunto una prueba de entrega y explico la identidad mTLS de los agentes; Observo la ausencia de datos como una laguna en la observación y no como la norma.
De forma gratuita almaceno Prometheus/Loki/Wazuh en un servidor seguro con respaldo, configuración y aprobaciones en Git, e incidencias en un sistema de tickets. Registro mensualmente coberturas, lagunas, prueba de alertas y lista de excepciones, firmo el informe y limito el acceso; el instrumento en sí, sin un procedimiento de cierre, no es prueba de control.
Con los Servers Sentinel divido la flota por equipo/inquilino, asigno roles de espectador, operador y administrador y aplico plantillas básicas con excepciones de clientes. Clasifico todos los hosts por puntuación de estado, envío notificaciones al propietario y uso la opción Business/autohospedado cuando se necesita aislamiento y una flota ilimitada.
De forma gratuita, implemento arrendamientos/instancias de Prometheus separados o aíslo datos con etiquetas estrictas y ACL en Grafana, almacenando secretos del cliente en diferentes bóvedas. Genero una configuración a partir del inventario, dirijo Alertmanager por inquilino/propietario y pruebo el bloqueo del acceso cruzado; La tenencia múltiple segura requiere más trabajo que un panel compartido.
Con Servers Sentinel firmo hosts por rol y propietario, almaceno series de métricas, plantillas globales y anulaciones explícitas, y asocio canales con propietarios. Utilizo el historial como base, documento el motivo del umbral no estándar junto al proceso de cambio y le doy al nuevo operador una función de solo visualización antes de transferir autoridad.
De forma gratuita, mantengo inventario y runbooks en Git, agrego enlaces al panel, propietario, dependencias y fundamentos para cada anulación, y acepto cambios mediante solicitud de extracción. Almaceno el aprovisionamiento de Grafana/Prometheus como código, marco la implementación/mantenimiento y transfiero el incidente a otro empleado una vez por trimestre; Sin práctica organizacional, los gráficos en sí no retendrán el conocimiento.
Con los Servers Sentinel utilizo una conexión saliente TLS mutua: cada agente recibe un certificado de cliente y el token de conexión de corta duración no reemplaza la identidad ya emitida. Verifico los derechos del servicio, la lista de métricas y registros recopilados, desactivo acciones innecesarias, implemento el piloto en un host y controlo la revocación del certificado cuando se elimina el servidor.
De forma gratuita, instalo node_exporter/windows_exporter en una cuenta separada sin privilegios, escucho solo localhost/VPN y limito el conjunto de recopiladores. Protejo el scrape con TLS/mTLS o ACL de red, firmo paquetes, confirmo versiones, busco actualizaciones y no habilito secuencias de comandos de archivos de texto que escriben desde fuentes que no son de confianza; Separo la gestión de la configuración del seguimiento.
Tres preguntas que merecen respuesta antes de desplegar nada con permisos de administrador en un parque en producción.
Servers Sentinel lo escribe Victor G. Bobrov, especialista principal en seguridad de servidores en Recovery Toolbox: más de 20 años en ingeniería de sistemas y seguridad y certificaciones Microsoft MCSD/MCDBA. La puntuación de salud, las reglas de alerta y la documentación de este sitio son su trabajo, publicados con su nombre y no bajo una marca anónima. Documentación →
El proveedor es File Master LLC, empresa registrada en Bulgaria (UE): Bulstat/IVA 180842207, oficina en Varna, localizable por teléfono y correo. Los pagos los gestiona PayPro Global como comerciante registrado; los términos, la política de privacidad y el acuerdo de tratamiento de datos están publicados íntegros, no resumidos. Términos del servicio · Privacidad · DPA
El agente lee métricas locales y el registro de autenticación de su propio host y los envía hacia fuera por TLS mutuo. No abre ningún puerto entrante ni tiene canal de comandos remotos: desde fuera no se le puede ordenar que ejecute nada en su servidor. Cada agente se inscribe con un certificado de cliente y el token de inscripción es de vida corta: uno robado no puede suplantar a un host ya inscrito. El propio panel se despliega como una pila docker-compose en su propio hardware. Instalar el agente →
La monitorización de un parque no es un tema en sí mismo: está entre las plataformas que observa, las herramientas que la precedieron y las normas con las que se mide un servidor. Estas son las fuentes que definen cada uno de ellos.
Los enlaces llevan a las fuentes mismas: Wikidata cuando la entidad tiene identificador y la fuente primaria cuando no.
Datos de contacto de Recovery Toolbox y File Master LLC, además del perfil de Victor G. Bobrov, especialista principal en seguridad de la empresa.
File Master LLC es la entidad jurídica detrás de los servicios en línea y los productos de software de Recovery Toolbox.
File Master LLC desarrolla y mantiene los servicios en línea y los productos de software de Recovery Toolbox para reparar archivos, bases de datos y formatos de correo dañados. La empresa se centra en herramientas de recuperación prácticas para usuarios, especialistas de TI y empresas que necesitan restaurar el acceso a datos dañados.
Sus comentarios y sugerencias son bienvenidos. Envíenos su opinión sobre el sitio web por correo electrónico: webmaster@recoverytoolbox.com
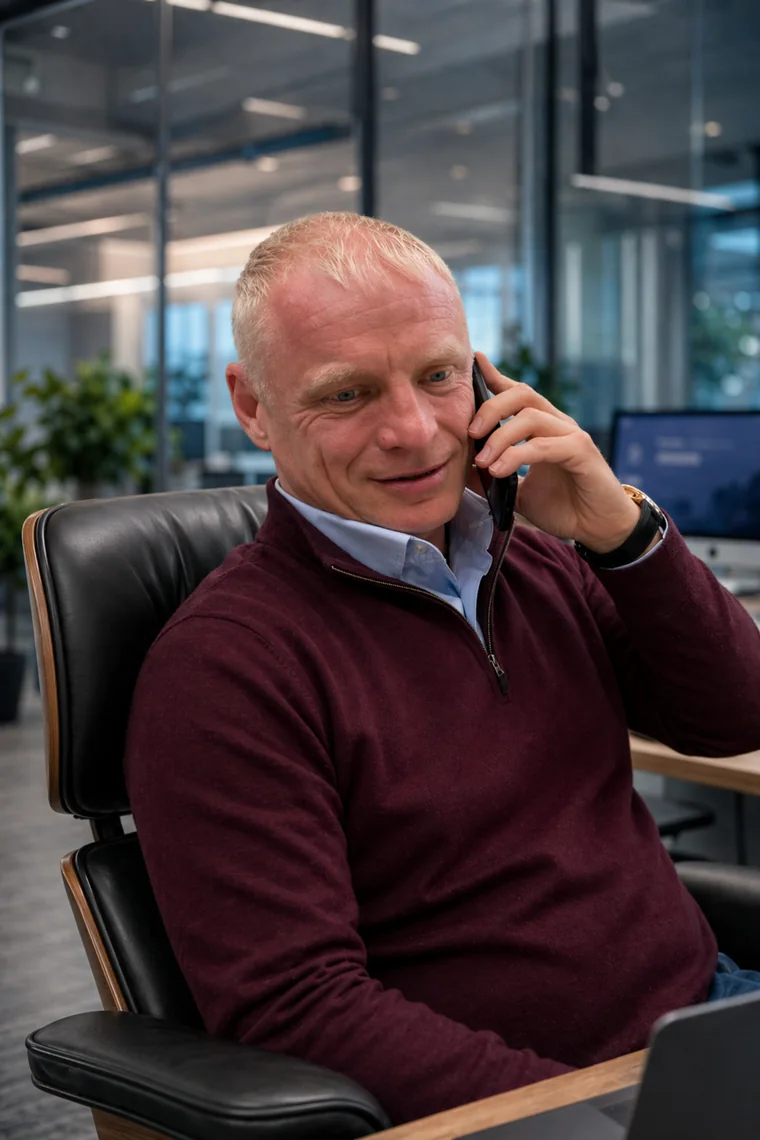
Especialista en seguridad de servidores · más de 20 años en ingeniería de sistemas y seguridad
Victor G. Bobrov dirige la ingeniería de seguridad en File Master LLC / Recovery Toolbox. Define qué vigila Servers Sentinel en un parque de servidores: la puntuación de salud detrás de las métricas de un host, la actividad de fuerza bruta en sus registros de autenticación, la desviación de configuración respecto a los CIS y las alertas que deben dispararse antes de que un administrador note nada.
Microsoft Certified Solutions Developer - MCSD. Microsoft Certified Database Administrator - MCDBA.
Añade un host, ejecuta una línea y míralo reportar en un minuto. El primer servidor es gratis.